
چکیده:
هوش مصنوعی این پتانسیل را دارد که با هدایت توسعهی راهبردهای درمانی مؤثر و متناسب با نیازهای فردی بیماران، مدیریت درد مزمن را متحول کند. این پتانسیل از توانایی هوش مصنوعی در تحلیل مجموعهدادههای بزرگ و متنوع برای شناسایی الگوهای پنهان ناشی میشود. وقتی هوش مصنوعی بر مجموعهدادههای بالینی یک جمعیت خاص از بیماران اعمال میشود، میتوان از آن برای شناسایی زیرگروههای درد در بین بیماران، پیشبینی پاسخهای درمانی و هدایت فرآیند تصمیمگیری بالینی استفاده کرد. با این حال، ادغام هوش مصنوعی در عمل بالینی مستلزم غلبه بر چالشهایی مانند کیفیت دادهها، پیچیدگی فیزیولوژی درد انسان و اعتبارسنجی در جمعیتهای متنوع بیماران است. تلاشهای هدفمند و مشارکتی بین پزشکان، محققان و متخصصان هوش مصنوعی برای به حداکثر رساندن قابلیتهای هوش مصنوعی و پیشبرد مدیریت و درمان فعلی شرایط درد مزمن ضروری خواهد بود.
سوالاتی که در این مقاله پاسخ داده شده است:
به چه روشهایی هوش مصنوعی میتواند پیشرفت بیماریهای درد مزمن را پیشبینی کند؟
هوش مصنوعی میتواند با تحلیل مجموعهدادههای بزرگ بیماران، الگوها، همبستگیها و نشانگرهای زیستی مرتبط با پروفایلهای درد خاص را کشف کند و پیشرفت بیماریهای درد مزمن را پیشبینی کند. این قابلیت پیشبینی به هوش مصنوعی امکان میدهد افرادی را که در معرض خطر ابتلا به عوارض هستند شناسایی کرده و مداخلات زودهنگام را برای کاهش پیامدهای نامطلوب توصیه کند.
چگونه جمعآوری مؤثر دادهها به مدیریت درد مزمن شخصیسازیشده کمک میکند؟
جمعآوری مؤثر دادهها با ایجاد روشهای استاندارد که امکان ادغام دادههای متنوع بیماران در الگوریتمهای هوش مصنوعی را فراهم میکند، مدیریت درد مزمن شخصیسازیشده را بهبود میبخشد. این رویکرد الگوهای پنهان بین بیماران را آشکار میکند و مداخلات متناسب با نیازها و ویژگیهای فردی را تسهیل میکند و در نهایت نتایج درمان را بهبود میبخشد.
چرا بیماریهای درد مزمن اولیه به ویژه برای بیماران و ارائهدهندگان مراقبتهای بهداشتی چالشبرانگیز هستند؟
بیماریهای درد مزمن اولیه به دلیل ماهیت پیچیده خود، که از ترکیبی از عوامل بیولوژیکی، روانی و اجتماعی ناشی میشود، به ویژه برای بیماران و ارائهدهندگان مراقبتهای بهداشتی چالشبرانگیز هستند. این پیچیدگی شناسایی اجزای متغیر مؤثر در ایجاد درد مزمن را دشوار میکند و در نتیجه اثربخشی درمانهای هدفمند را محدود میکند. علاوه بر این، بسیاری از افراد مبتلا به درد مزمن در طول زمان سطوح مشابه یا حتی افزایش یافتهای از درد را تجربه میکنند که تلاشهای مدیریتی را پیچیده میکند.
چه روندهای نوظهوری برای رفع چالشهای مدیریت درد مزمن در حال بررسی است؟
روندهای نوظهور در رفع چالشهای مدیریت درد مزمن شامل استفاده از هوش مصنوعی برای شخصیسازی راهبردهای درمانی است. این رویکرد با هدف بهبود نتایج از طریق باز کردن گره تعامل پیچیده عوامل بیولوژیکی، روانی و اجتماعی که در درد مزمن نقش دارند، انجام میشود.
الگوریتمهای هوش مصنوعی چگونه ایجاد برنامههای ورزشی فردی برای درد اسکلتی عضلانی را تسهیل میکنند؟
الگوریتمهای هوش مصنوعی با تحلیل علائم بیمار و تنظیم راهبردهای درمانی برای برآورده کردن نیازهای منحصر به فرد هر بیمار، ایجاد برنامههای ورزشی فردی برای درد اسکلتی عضلانی را تسهیل میکنند. این رویکرد بیمارمحور اثربخشی مدیریت درد را با اطمینان از اینکه رژیمهای ورزشی به طور خاص بر اساس وضعیت فرد طراحی شدهاند، افزایش میدهد.
۱. مقدمه
درد مزمن بار سنگینی را بر افراد، جوامع و سیستمهای مراقبتهای بهداشتی تحمیل میکند و اختلالات عمیقی در زندگی روزمره ایجاد میکند که اغلب منجر به جستجوی مداوم برای مراقبتهای پزشکی و تسکین درد میشود. درد مزمن تأثیرات اجتماعی-اقتصادی قابل توجهی دارد، به طوری که فقط در ایالات متحده به طور متوسط سالانه 560 تا 635 میلیارد دلار تخمین زده میشود (گاسکین و ریچارد، 2012؛ پارک و همکاران، 2016). در حالی که درد حاد اغلب به عنوان یک سیگنال بیولوژیکی مستقیم از یک آسیب یا بیماری زمینهای عمل میکند، درد مزمن از یک تعامل پیچیده از عوامل بیولوژیکی، روانی و اجتماعی ناشی میشود که فراتر از درد مورد انتظار از علت اولیه قابل شناسایی است. در نتیجه، شناسایی اجزای متغیر که در ایجاد درد مزمن نقش دارند، چالش برانگیز است و این امر توسعه درمانهای هدفمند مؤثر را محدود میکند. به عنوان مثال، شرایط درد مزمن اولیه، مانند درد گسترده مزمن (از جمله فیبرومیالژیا)، سردردهای مزمن اولیه و بسیاری از شرایط درد گردن و کمر (نیکلاس و همکاران، 2019)، چالش بزرگی را برای بیماران و ارائه دهندگان مراقبتهای بهداشتی ایجاد میکند، و مدیریت درد به دلیل ماهیت مبهم پاتوفیزیولوژی زمینهای آنها، عمدتاً رضایتبخش نیست. در نهایت، غلبه بر درد مزمن نیز به طرز بدنامی دشوار است. در واقع، بیش از 60 درصد از افراد مبتلا به درد مزمن، در سال بعد سطوح مشابه یا حتی افزایش یافتهای از درد را گزارش میکنند (ناهین و همکاران، 2023). این تفسیر با هدف ارائه یک مرور مختصر از چالشهای مربوط به توصیف و مدیریت درد مزمن و روندهای نوظهور در استفاده از هوش مصنوعی برای رفع این چالشها ارائه میشود.
عوامل متعددی در تداوم درد مزمن نقش دارند:
- عدم کارایی رویکردهای درمانی موجود: بسیاری از افراد مبتلا به درد مزمن همچنان با تسکین ناکافی و اختلال عملکرد مواجه هستند. در واقع، علیرغم مدیریت چندرشتهای در ثبتهای بالینی گسترده درد، فقط یک نفر از هر چهار نفر بهبود قابل توجهی در درد را گزارش میکند (واگتر و همکاران، 2021؛ تاردف و همکاران، 2017). این تسکین ناکارآمد درد تا حدی به این دلیل است که رویکردهای مرسوم اغلب علائم فرد را هدف قرار میدهند، نه مکانیسمهای زمینهای که محرک درد مزمن هستند. بدون درک روشن از پاتوفیزیولوژی زمینهای، ارائه دهندگان مراقبتهای بهداشتی اغلب به رویکردهای آزمون و خطا تکیه میکنند که اغلب منجر به نتایج نامطلوب و بارهای درمانی غیرضروری برای بیمار میشود. علاوه بر این، استفاده طولانی مدت از داروهای مسکن، به ویژه مواد افیونی، با عوارض جانبی و خطرات شدید مرتبط است (وبستر، 2017).
- تفاوتهای ذاتی بین بیماران: تفاوتهای ذاتی فردی، از جمله جنسیت بیولوژیکی و جنسیتی، استعدادهای ژنتیکی، عوامل روانی-اجتماعی و سایر موارد، در تجربیات متنوع درد مشاهده شده در بین بیماران نقش دارند (شاه و همکاران، 2024). در نتیجه، رویکرد یکسان برای همه در مدیریت درد ناکافی است. در عوض، رویکردهای مدیریت درد باید از مداخلاتی متناسب با نیازها و ویژگیهای منحصر به فرد هر فرد بهرهمند شوند.
- تغییرپذیری در علائم و پاسخ به درمان: درد مزمن خود را در اشکال متنوعی نشان میدهد، از جمله درد نوسیسپتیو (ناشی از آسیب بافتی)، نوسیسپلاستیک (مربوط به پردازش درد تغییر یافته توسط سیستم عصبی) و نوروپاتیک (ناشی از آسیب یا اختلال عملکرد عصبی)، که اغلب چندین ناحیه بدن را تحت تأثیر قرار میدهد و با بیماریهای همراه مختلف همزمان رخ میدهد. با توجه به تفاوتهای ذاتی ذکر شده در درک درد، افراد با تشخیصهای یکسان ممکن است تجربیات درد و پاسخهای متفاوتی به درمانها ارائه دهند. این تغییرپذیری چالش قابل توجهی را برای ارائه دهندگان مراقبتهای بهداشتی در سفارشی کردن درمانها برای هر بیمار ایجاد میکند.
- محدودیت در دسترس بودن ابزار برای زیرگروهبندی درد: ماهیت ذهنی درد یکی از بزرگترین چالشها برای غلبه بر آن در جهت توسعه استراتژیهای درمانی مؤثر است. در حالی که برخی از نشانگرهای زیستی درد شناسایی شدهاند (فاورتتی و همکاران، 2023)، طبقهبندی و کمیسازی دقیق زیرگروههای متمایز درد معمولاً به روشهای آزمایش استاندارد، مانند آزمایش حسی کمی (QST) متکی است. آزمایش QST شامل مجموعهای از آزمایشهای غیرتهاجمی است که پاسخ فرد را به طیف وسیعی از محرکهای حرارتی و مکانیکی کالیبره شده اندازهگیری میکند. در حالی که این روشها میتوانند درک بهتری از عملکرد (اختلال) حسی-پیکری بیمار ارائه دهند، پروتکلهای QST زمانبر هستند و به پرسنل آموزش دیده و تجهیزات خاصی نیاز دارند که معمولاً در محیطهای بالینی وجود ندارند (بلوستا-لوپز و همکاران، 2023). توسعه پروتکلهای QST “بالینی” امکان پذیرش این روشها را در استاندارد مراقبت برای توصیف عینی تظاهرات درد بیمار و نظارت بر نتایج درمان فراهم میکند.
هوش مصنوعی (AI) به طور کلی فناوریهایی را تعریف میکند که رایانهها را قادر میسازد وظایفی شبیه به هوش انسانی را انجام دهند. یادگیری ماشین (ML)، زیرمجموعهای از هوش مصنوعی، بر یادگیری از دادهها برای پیشبینی یا پیشنهاد تصمیمگیری بر اساس الگوهای شناسایی شده تمرکز دارد. دو نوع اصلی یادگیری ماشین وجود دارد: یادگیری نظارت شده و یادگیری نظارت نشده. یادگیری نظارت شده شامل آموزش یک مدل با دادههای برچسبگذاری شده است، جایی که الگوریتم یاد میگیرد ورودیها را به خروجیهای مطلوب نگاشت کند. به عنوان مثال، در مراقبتهای بهداشتی، میتوان آن را آموزش داد تا یک تومور را بر اساس نمونههای برچسبگذاری شده ارائه شده توسط پزشکان، به عنوان بدخیم یا غیربدخیم طبقهبندی کند (وان و همکاران، 2020). در مقابل، یادگیری نظارت نشده دادهها را بدون برچسبهای از پیش تعریف شده بررسی میکند تا الگوها یا ساختارهای پنهان را در آن کشف کند. در کاربردهای مراقبتهای بهداشتی، این ممکن است شامل خوشهبندی بیماران به گروههایی با ویژگیهای پاتولوژیک مشابه بدون طبقهبندی قبلی باشد (کوموروفسکی و همکاران، 2022).
هوش مصنوعی وعده قابل توجهی برای متحول کردن جنبههای مختلف سازمانهای مراقبتهای بهداشتی دارد و فرصتهایی را برای افزایش دقت تشخیصی، بهینهسازی نتایج درمان یا مدیریت بالینی و سادهسازی گردش کار بالینی ارائه میدهد. در زمینه مدیریت درد مزمن، رویکردهای مبتنی بر هوش مصنوعی این پتانسیل را دارند که استراتژیهای درمانی شخصیسازی شده را شناسایی کنند که متناسب با ویژگیها و نیازهای منحصر به فرد هر بیمار باشد. با تجزیه و تحلیل مجموعههای داده بزرگ بیماران، هوش مصنوعی میتواند الگوها، همبستگیها و نشانگرهای زیستی مرتبط با پروفایلهای درد خاص را کشف کند. این قابلیت پیشبینی همچنین میتواند هوش مصنوعی را قادر سازد تا پیشرفت شرایط درد مزمن را پیشبینی کند، افرادی را که در معرض خطر ابتلا به عوارض هستند شناسایی کند یا مداخلات زودهنگام را برای کاهش نتایج نامطلوب توصیه کند. در نتیجه، هوش مصنوعی میتواند در بسیاری از جنبههای مراقبتهای بالینی برای بیماران مبتلا به درد مزمن اعمال شود. با این حال، دستیابی به الگوریتمهای هوش مصنوعی قابل اعتماد برای استفاده بالینی، نیازمند ملاحظات دقیق در طراحی آزمایش، جمعآوری دقیق دادهها و تجزیه و تحلیل دقیق در مطالعات بالینی مبتنی بر هوش مصنوعی است.
۲. نقش هوش مصنوعی در تحقیقات پزشکی
هوش مصنوعی جنبههایی از هر دو حوزه تحقیقات پیشبالینی و بالینی را متحول کرده است. در تحقیقات پیشبالینی، هوش مصنوعی تحلیل دقیق مجموعه دادههای بزرگ از مدلهای حیوانی را امکانپذیر میکند، تنظیم آزمایشهای درونتنی را بهینه میکند و مدلسازی پیشبینیکننده برای آزمایش گزینههای درمانی را تسهیل میکند. در محیطهای بالینی، هوش مصنوعی میتواند مراقبت از بیمار را از طریق رویکردهای پزشکی شخصیسازی شده بهینه کند، دادههای بیمار را برای پیشبینی نتایج، توصیه برنامههای درمانی و شناسایی خطرات احتمالی تجزیه و تحلیل کند.
در تحقیقات پیشبالینی، هوش مصنوعی عمدتاً برای افزایش کارایی توسعه دارویی مولکولهای کوچک درونرایانهای و درونتنی از طریق پیشبینی ساختارهای سهبعدی هدف و افزایش دانش تعامل هدف-دارو مورد استفاده قرار گرفته است (ادلفلدت و همکاران، 2011؛ ووکویچ و هاگینز، 2018). علیرغم دادههای ساختاری تجربی از پیش موجود برای تنها 35 درصد از پروتئوم انسانی، روشهای محاسباتی مانند مدلسازی همولوژی و الگوریتمهای یادگیری عمیق (DL) پیشرفته، مانند آلفافولد2 (جامپر و همکاران، 2021)، دقت پیشبینی ساختار پروتئین را به حدی بهبود بخشیدهاند که با روشهای تجربی قابل مقایسه است. به موازات آن، یک شبکه عصبی کانولوشنال (CNN) مبتنی بر DL، دیپلیتاف (سیمونوفسکی و مایرز، 2020)، از نمایشهای مبتنی بر وکسل برای مقایسه محلهای اتصال بدون سوگیری توالی استفاده میکند و ارزیابیهای مقیاسپذیر و دقیقی را ارائه میدهد که به پیشبینی تعاملات هدف-دارو کمک میکند. علاوه بر این، روشهای مبتنی بر هوش مصنوعی، مانند غربالگری مجازی مبتنی بر لیگاند (LBVS) و مبتنی بر ساختار (SBVS)، اولویتبندی ترکیبات را برای غربالگری تجربی با کاوش در کل فضای شیمیایی برای شناسایی ضربه و ارتقای امیدوارکنندهترین ترکیبات به آزمایش درونتنی افزایش میدهند (وازکز و همکاران، 2020). در نهایت، الگوریتمهای ML و DL برای پیشبینی خواص جذب، توزیع، متابولیسم، دفع و سمیت (ADMET) ترکیبات دارویی استفاده شدهاند (هانش و همکاران، 1962؛ فری جونیور و ویلسون، 1964). رشته بزرگ دیگری از کاربرد هوش مصنوعی در تحقیقات پیشبالینی شامل خودکارسازی پردازش تصاویر میکروسکوپی از طریق شبکههای عصبی DL است، که نمونهای از آن توسط سارتی و همکاران برای پاسخهای جسم خارجی ارائه شده است (سارتی و همکاران، 2021).
در محیط بالینی، هوش مصنوعی میتواند به عنوان ابزار پشتیبانی تصمیمگیری برای ارائه دهندگان مراقبتهای بهداشتی عمل کند و بینشها و توصیههای عملی را برای هدایت تصمیمات درمانی بر اساس پروفایلهای فردی بیمار ارائه دهد (حلیم و همکاران، 2019). تصویربرداری پزشکی یکی از زمینههای بالینی است که به طور عمده تحت تأثیر کاربردهای هوش مصنوعی قرار گرفته است و حجم رو به رشدی از تحقیقات در این زمینه وجود دارد، به عنوان مثال، با بهبود موقعیتیابی بیمار و بازسازی تصویر CT (حبیبزاده و همکاران، 2012)، تسریع معاینات MRI با کاهش زمان اسکن (ترزیس و همکاران، 2024)، خودکارسازی تشخیص و اندازهگیریهای سونوگرافی (رینک و همکاران، 2024) و بهینهسازی تفسیر رادیولوژی و پیشآگهی مبتنی بر رادیولوژی (هیو و همکاران، 2024)، تسهیل ادغام دادههای بیمار در حوزههای بالینی. علاوه بر این، مطالعات مبتنی بر هوش مصنوعی در کشف نشانگرهای زیستی که میتواند تشخیص و نتیجه بیمار را به طور قابل توجهی بهبود بخشد، با پردازش مجموعه دادههای عظیم اطلاعات مولکولی، شناسایی الگوها و همبستگی آنها با حالات بیماری، نقش مهمی ایفا کردهاند. هوش مصنوعی میتواند امضاهای مولکولی خاصی را که روشهای سنتی ممکن است از دست بدهند، متمایز کند، دقت را در کشف نشانگرهای زیستی افزایش دهد و به طور بالقوه شاخصهای جدیدی از آسیبشناسی را آشکار کند. نمونههای موفق در چندین آسیبشناسی گسترده است: نارسایی قلبی (راسنگ و همکاران، 2016؛ جیانگ و همکاران، 2014؛ نایور و همکاران، 2020؛ فریرا و همکاران، 2021)، سرطان (پرلاج و همکاران، 2024؛ منصور و همکاران، 2023؛ هورژ، 2023)، آلزایمر (وینچستر و همکاران، 2023)، بیماریهای تنفسی (یاگین و همکاران، 2023)، سپسیس (کوموروفسکی و همکاران، 2022) و سایر موارد.
هوش مصنوعی همچنین به طور فزایندهای برای پیشبرد رویکردهای نوآورانه برای مدیریت درد مورد استفاده قرار میگیرد (ناگیردی و همکاران، 2022). به عنوان مثال، الگوریتمهای هوش مصنوعی مشخصهسازی درد را از طریق چندین روش بهبود میبخشند: ارزیابی درد از یادداشتهای بالینی بدون ساختار (فوده و همکاران، 2018)، طبقهبندی درک درد از طریق تجزیه و تحلیل حالات چهره (لوتش و همکاران، 2018؛ نیکرسون و همکاران، 2016؛ گائو و همکاران، 2021) و تسهیل ارزیابی عینی درد با استفاده از دستگاههایی مانند حسگرهای فعالیت الکترودرمال (گورنور و همکاران، 2023). در مدیریت بالینی درد، هوش مصنوعی از توسعه درمانهای بیمار محور پشتیبانی میکند، مانند ایجاد برنامههای ورزشی فردی برای درد اسکلتی عضلانی بر اساس علائم (آنان و همکاران، 2021) و شامل برنامههای تلفن همراه مبتنی بر هوش مصنوعی موجود در بازار مانند selfBACK برای پشتیبانی از تصمیمگیری در خودمدیریتی درد مزمن کمر (سندال و همکاران، 2021). هوش مصنوعی همچنین در شناسایی نشانگرهای زیستی مغزی مبتنی بر تصویربرداری عصبی که پاسخ به درمان را در بیماران مبتلا به درد نشان میدهد، استفاده میشود (هانگ و همکاران، 2022؛ هانگ و همکاران، 2021). علاوه بر این، الگوریتمهای هوش مصنوعی برای پیشبینی حالات درد مزمن خود به خودی به کار گرفته شدهاند و به برنامهریزی مداخلات هدفمند کمک میکنند (شیروالکار و همکاران، 2023) و مطالعات اخیر اثربخشی تحریک عمیق مغزی را در تعدیل درک درد بر اساس پیشبینیهای هوش مصنوعی بررسی میکنند (داتا و ناچامای، 2018؛ خرغانیان و همکاران، 2016؛ لوسی و همکاران، 2011؛ فونتین و همکاران، 2022). این کاربردها نقش چندوجهی هوش مصنوعی را در بهبود ارزیابی درد، درمان و نتایج بیمار برجسته میکنند. در مجموع، این پیشرفتها نقش رو به رشد هوش مصنوعی را در شخصیسازی و بهبود استراتژیهای مدیریت درد نشان میدهند.
۳. مزایای بالقوه استفاده از هوش مصنوعی برای سفارشیسازی مدیریت درد مزمن
رویکرد پذیرفته شده فعلی در مدیریت درد مزمن، رویکردی جامع است. این رویکرد تلاش میکند به جنبههای متعدد درد مزمن بپردازد و شامل ارزیابی کامل عوامل بیولوژیکی و روانی-اجتماعی و استفاده از مداخلات چندوجهی است (دستورالعملهای عملی برای مدیریت درد مزمن، 2010). علیرغم تلاشها برای تطبیق درمان با بیمار، یک مطالعه طولی نشان میدهد که اکثریت افراد مبتلا به درد مزمن، یک سال بعد همچنان درد یا درد با تأثیر بالا را گزارش میکنند (ناهین و همکاران، 2023). شخصیسازی استراتژیهای درمانی برای بهبود نتایج در مدیریت درد مزمن، که وظیفهای پیچیده است و هوش مصنوعی میتواند به حل آن کمک کند، ضروری خواهد بود.
یک نقشه راه آزمایشی برای سفارشیسازی استراتژیهای مدیریت درد مزمن از طریق استفاده ویژه از هوش مصنوعی، شامل مشخصهسازی و طبقهبندی عمیق جمعیت بیمار برای تعریف پروفایلهای درد موجود، و به دنبال آن مطالعات بالینی است که پیامدهای یک مداخله را بر پروفایل درد فرد مشخص میکند. این نقشه راه در شکل 1 ارائه شده است و شامل مراحل اساسی زیر است:
جمعآوری دادهها: جمعآوری دادههای مؤثر برای توسعه استراتژیهای مدیریت درد مزمن شخصیسازی شده بسیار مهم است. این امر شامل جمعآوری سوابق بیمار، اطلاعات جمعیتی، سوابق پزشکی، گزارشهای علائم، نتایج تصویربرداری و عوامل روانی-اجتماعی و سبک زندگی برای اطمینان از درک جامع تجربه درد منحصر به فرد هر بیمار است. استفاده از ابزارهای پیشرفته انفورماتیک برای ادغام و تجزیه و تحلیل این مجموعههای داده چندبعدی، دقت خوشهبندی و تولید بینشها را افزایش میدهد.
خوشهبندی بیماران بر اساس تظاهرات درد: الگوریتمهای هوش مصنوعی میتوانند انواع مختلف دادهها را از منابع متمایز تجزیه و تحلیل کنند تا بیماران را بر اساس ویژگیهای مشترک به زیرگروهها یا خوشههای درد جداگانه طبقهبندی کنند. گروهبندی بیماران بر اساس تظاهرات درد آنها برای طراحی و ارزیابی مداخلات هدفمند متناسب با ارائه و/یا نیازهای منحصر به فرد هر خوشه، محوری است. روشهای خوشهبندی استاندارد عبارتند از: خوشهبندی K-Means، که با به حداقل رساندن واریانس در هر یک از آنها، بیماران را به تعداد از پیش تعریف شده خوشههای شناخته شده تقسیم میکند، زمانی مفید است که تعداد خوشهها از قبل مشخص باشد؛ خوشهبندی سلسله مراتبی، که یک ساختار درخت مانند از خوشهها ایجاد میکند و انعطافپذیری در بررسی روابط بین تظاهرات مختلف درد را از طریق روشهای تجمعی (پایین به بالا) یا تقسیمی (بالا به پایین) ارائه میدهد؛ DBSCAN (خوشهبندی فضایی مبتنی بر تراکم برنامههای کاربردی با نویز)، که خوشهها را بر اساس تراکم نقاط داده شناسایی میکند و آن را برای تشخیص خوشههایی با اشکال و اندازههای مختلف در حین مدیریت نویز و دادههای پرت مؤثر میسازد؛ مدلهای مخلوط گوسی (GMMs)، که از یک رویکرد احتمالی برای مدلسازی دادهها به عنوان مخلوطی از توزیعهای گوسی استفاده میکند و امکان خوشههای همپوشانی را فراهم میکند و توزیعهای احتمالی عضویت خوشه را ارائه میدهد. علاوه بر این، t-SNE (تعبیه همسایه تصادفی توزیع شده t) و UMAP (تقریب و طرحریزی منیفولد یکنواخت) تکنیکهای کاهش ابعاد هستند که اغلب برای تجسم دادههای با ابعاد بالا و شناسایی خوشههای معنادار بر اساس ویژگیهای درد بیمار استفاده میشوند.
اعتبارسنجی خوشهبندی: اعتبارسنجی یک گام حیاتی برای اطمینان از استحکام و قابلیت اطمینان نتایج خوشهبندی است و میتواند از تکنیکها و معیارهای مختلفی استفاده کند. تجزیه و تحلیل امتیاز شبح اندازهگیری میکند که هر نقطه داده در مقایسه با خوشههای دیگر چقدر به خوشه خود شبیه است. امتیاز شبح متوسط بالا نشان دهنده خوشههای جدا شده و فشرده است، در حالی که امتیاز پایین نشان دهنده خوشههای همپوشانی یا ضعیف تعریف شده است. شاخص دیویس-بولدین نسبت شباهت متوسط هر خوشه را با مشابه ترین خوشه خود ارزیابی میکند و بینشهایی را در مورد جداسازی بین خوشهها ارائه میدهد؛ شاخص دیویس-بولدین پایینتر نشان دهنده کیفیت خوشهبندی بهتر است. علاوه بر این، روشهای اعتبارسنجی متقابل میتوانند قابلیت تعمیم الگوریتم خوشهبندی را ارزیابی کنند. در این رویکرد، مجموعه داده به k زیرمجموعه تقسیم میشود؛ الگوریتم خوشهبندی روی k-1 زیرمجموعه آموزش داده میشود و روی زیرمجموعه باقی مانده اعتبارسنجی میشود. این فرآیند k بار تکرار میشود و سازگاری نتایج خوشهبندی در زیرمجموعههای مختلف ارزیابی میشود تا اطمینان حاصل شود که خوشهها پایدار هستند و به یک پارتیشن داده خاص وابسته نیستند. در نهایت، اعتبارسنجی اضافی در برابر یک مجموعه داده تازه حاشیهنویسی شده میتواند دقت رویکرد خوشهبندی را بیشتر تأیید کند. این امر شامل اعمال الگوریتم خوشهبندی به یک مجموعه داده جدید با حاشیهنویسیهای شناخته شده یا برچسبهای متخصص است. مقایسه نتایج خوشهبندی با برچسبهای حاشیهنویسی شده کمک میکند تا تأیید شود که آیا خوشههای شناسایی شده توسط الگوریتم با گروهبندیهای مرتبط بالینی یا مورد انتظار همسو هستند یا خیر.
پروفایلبندی بیمار و طراحی استراتژی درمانی: تجزیه و تحلیل آماری توصیفی خوشههای به دست آمده، پروفایلهای درد فردی را ایجاد میکند. بر اساس این پروفایلها، پزشکان میتوانند مدیریت درد و مداخلات درمانی شخصیسازی شده، از جمله درمانهای دارویی و غیردارویی را توصیه کنند. پاسخ مثبت یا منفی بیمار به مداخله متعاقباً به یک مجموعه جامع از دادهها کمک میکند که میتواند برای توسعه مدلهای پیشبینی مبتنی بر هوش مصنوعی برای نتایج درمان بیشتر مورد مطالعه قرار گیرد. علاوه بر این، این پروفایلها ممکن است ویژگیهای جدید جالبی را آشکار کنند که میتوانند به عنوان اهداف درمانی جدید برای مدیریت درد مورد بررسی قرار گیرند.
پیشبینی پاسخ به درمان: گسترش کاربرد هوش مصنوعی برای پیشبینی پاسخ به درمان برای بیماران مبتلا به درد مزمن، گام طبیعی بعدی خواهد بود. این فرآیند نیازمند یک رویکرد دو مرحلهای است که آزمایشهای بالینی آیندهنگر و مدلسازی پیشبینی مبتنی بر هوش مصنوعی را ادغام میکند. ابتدا، مجموعهای از آزمایشهای بالینی اثربخشی و پاسخهای بیمار را به استراتژیهای مدیریت درد شخصیسازی شده که بر اساس پروفایل خوشهبندی (مرحله 4) تهیه شدهاند، آزمایش میکند. متعاقباً، نتایج این آزمایشهای بالینی به عنوان حقیقت اصلی برای توسعه مدل پیشبینی مبتنی بر هوش مصنوعی (رگرسیون لجستیک، جنگل تصادفی و غیره) برای پیشبینی پاسخهای فردی بیمار به درمانهای خاص عمل میکند. این رویکرد باید به ارائهدهندگان اجازه دهد تا بیماران را بر اساس استعداد آنها برای پاسخ یا عدم پاسخ به درمان مدیریت درد طبقهبندی کنند، که به طور حیاتی مفهوم طب درد دقیق را پیش میبرد. در نهایت، نتیجه آزمایشهای بالینی به اصلاح کل استراتژی کمک میکند، جمعآوری دادههای معنادارتر را هدایت میکند و در نتیجه خوشهبندی و مراحل بعدی را بهینه میکند.
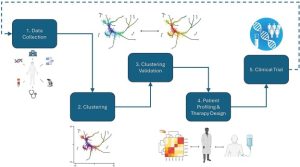
شکل 1. نقشه راه سفارشیسازی استراتژی مدیریت درد.
جمعآوری دادهها: جمعآوری دادههای جامع بیمار شامل سوابق، اطلاعات جمعیتی، سوابق پزشکی، گزارشهای علائم، نتایج تصویربرداری و عوامل روانی-اجتماعی.
خوشهبندی بیماران: الگوریتمهای هوش مصنوعی بیماران را با استفاده از روشهایی مانند K-Means، سلسله مراتبی، DBSCAN، GMMs، t-SNE و UMAP به زیرگروههای درد طبقهبندی میکنند.
اعتبارسنجی خوشهبندی: ارزیابی استحکام خوشهها با استفاده از معیارهایی مانند امتیاز شبح، شاخص دیویس-بولدین، اعتبارسنجی متقابل و مقایسه مجموعه دادههای حاشیهنویسی شده.
پروفایلبندی بیمار و طراحی درمانی: ایجاد پروفایلهای درد فردی برای هدایت استراتژیهای درمانی شخصیسازی شده و شناسایی اهداف جدید مدیریت درد.
پیشبینی پاسخ به درمان: استفاده از مدلهای هوش مصنوعی برای پیشبینی پاسخهای فردی به درمانها، اصلاح استراتژیها بر اساس نتایج آزمایشهای بالینی برای طب درد دقیق بهینه.
۴. چالشها و ملاحظات عملی
در حالی که نقشه راه ارائه شده در بالا ممکن است ساده به نظر برسد، دارای چندین هشدار و چالش است که نیازمند برنامهریزی دقیق و توسعه برنامههای احتمالی است.
اولین و مهمترین عنصر مورد نیاز برای مطالعات مبتنی بر هوش مصنوعی، دادههای با کیفیت بالا و ساختار یافته است. این الزام محققان را مجبور میکند تا جنبه جمعآوری دادههای مطالعات خود را به دقت بررسی و برنامهریزی کنند. محدودیت در دسترس بودن دادههای با کیفیت بالا، پراکندگی دادهها در منابع ناهمگون، و نگرانیهای مربوط به حریم خصوصی و امنیت، همراه با هزینههای مرتبط با راهاندازی مطالعات طولی و پیچیدگی اشتراکگذاری اطلاعات سلامت، ممکن است ملاحظات عملی را برای محققان و متخصصان مراقبتهای بهداشتی ایجاد کند. ایجاد پروتکلهای استاندارد و ایجاد انگیزه برای اشتراکگذاری دادهها در یک محیط علمی تیم بینرشتهای ممکن است به غلبه بر این مانع کمک کند.
در صورت امکان، دانشمندان باید به استانداردهای فراداده و عناصر داده بالینی رایج (CDEs) حوزه خود پایبند باشند. روشهای استاندارد جمعآوری دادههای امیدوارکننده برای محققان درد به عنوان بخشی از ابتکار عمل NIH برای کمک به پایان دادن به اعتیاد در بلندمدت (HEAL) ایجاد شده است (بیکر و همکاران، 2021). این برنامه از تمام مطالعات با بودجه HEAL میخواهد مجموعهای از CDEهای رایج را جمعآوری کنند که به روشی مشابه کدگذاری شده و ترجیحاً از طریق REDCap جمعآوری شوند (واندنر و همکاران، 2022). نکته مهم این است که CDEهای HEAL توسط گروههای تحقیقاتی مختلف در حال گسترش هستند تا عناصر داده رایج برای سایر انواع درد، مانند درد مفاصل، توسعه دهند (کروز-آلمیدا و همکاران، 2024). علاوه بر این، HEAL از همه دادههای تولید شده میخواهد که به صورت عمومی از طریق مخازن پشتیبانی شده HEAL به اشتراک گذاشته شوند. در مجموع، این الزامات مجموعههای داده باز و FAIR را ایجاد میکند که برای هوش مصنوعی/یادگیری ماشین آماده هستند، به این معنی که میتوانند به راحتی استخراج و در الگوریتمهای هوش مصنوعی ادغام شوند تا الگوهای پنهان را در بین بیماران مبتلا به درد یا اختلالات مصرف مواد کشف کنند.
ماهیت ذهنی درد، چالش بزرگ دیگری برای این خط تحقیق است. این امر ممکن است با تکمیل پرسشنامههای استاندارد ارزیابی درد با مطالعات کمی عمیق، مانند آزمایش QST، که اغلب به دلیل محدودیتهای هزینه و زمان در محیطهای بالینی حذف میشوند، برطرف شود. علاوه بر این، ادغام مجموعههای داده فعلی در مورد تجربه درد با تکنیکهای تصویربرداری عصبی میتواند به همبستگی تظاهرات درد (به طور بالقوه ذهنی) با ارزیابیهای کمی (عینی) کمک کند. در مجموع، چنین تغییراتی میتواند به ترسیم تصویر کاملتری از تجربه درد بیمار کمک کند.
امکانپذیری استفاده از الگوریتمهای مبتنی بر هوش مصنوعی برای بهبود مدیریت درد برای یک گروه بیمار خاص و/یا اختلال، تحت تأثیر اندازه و ناهمگونی جمعیت بیمار قرار میگیرد و ممکن است برای مطالعه اختلالات نادر چالشبرانگیز باشد. راه حلهای بالقوه برای غلبه بر این مانع شامل ایجاد کنسرسیومهای بینالمللی چند مرکزی و ثبتهای بیمار است که امکان اشتراکگذاری دادهها را در بین موسسات فراهم میکند. مطالعه تحقیقاتی درد کمر (LB3P) نمونهای از چنین پروژه چند مرکزی و چند رشتهای است. LB3P با هدف پرداختن به پیچیدگی مدیریت درد مزمن کمر از طریق فنوتیپبندی عمیق بیماران، تولید یک بدنه بزرگ از دادههای بیولوژیکی، بیومکانیکی و رفتاری است (وو و همکاران، 2023). از دیدگاه محاسباتی، یادگیری انتقالی (یعنی اعمال مدلهایی که با موفقیت بر روی وظایف مشابه از پیش آموزش داده شدهاند با تنظیم دقیق آنها بر روی یک مجموعه داده خاص) میتواند از توسعه الگوریتم مبتنی بر هوش مصنوعی برای بیماریهای نادر، با شروع از دانش بیماریهای مرتبط با درد مزمن شناخته شده و کمتر نادر، پشتیبانی کند.
نکته مهم این است که اثربخشی و دقت الگوریتمهای مبتنی بر هوش مصنوعی میتواند تحت تأثیر عوامل متعددی از جمله سوگیری و اعتبارسنجی محدود در عمل بالینی قرار گیرد. یک رویکرد منطقی برای کاهش سوگیری، انجام تجزیه و تحلیل حساسیت است که مستلزم ایجاد گروههای اعتبارسنجی در مقیاس بزرگ از جمعیتهای بیمار بزرگ و متنوع است. بنابراین، مطالعات چند مرکزی برای ایجاد چنین جمعیتهایی و متعاقباً انجام مطالعات اعتبارسنجی آیندهنگر در محیطهای بالینی واقعی مورد نیاز خواهد بود. از طرف دیگر، اعتبارسنجی محدود در عمل بالینی باید با ایجاد پروتکلهای اعتبارسنجی دقیق که با استانداردها و دستورالعملهای بالینی همسو هستند، یعنی انجام مطالعات آیندهنگر با گروههای خوشتعریف برای اعتبارسنجی الگوریتمهای هوش مصنوعی در برابر نتایج و معیارهای بالینی تثبیت شده، مورد توجه قرار گیرد. علاوه بر این، ادغام مکانیسمهای بازخورد که به پزشکان اجازه میدهد بینشهایی را ارائه دهند و پیشبینیهای الگوریتمی را در عمل روزانه خود اعتبارسنجی کنند، اعتبار و قابلیت استفاده را افزایش میدهد.
در نهایت، تبدیل یافته های محاسباتی تأییدشده به استراتژیهای درمانی شخصی سازی شده (فرایندی متفاوت از اعتبارسنجی) با چالشهای متعددی رو به روست که میانگین تأخیر ۱۵ تا ۱۷ ساله بین انتشار دستورالعملها و اجرای عملی آنها را توجیه میکند( Hassan و همکاران، ۲۰۲۳). بخشی از این مشکل ناشی از دشواریِ متقاعدکردن پزشکان برای ادغام رویکردهای نوین در روشهای درمانی تثبیت شده – به ویژه در محیطهای غیرآکادمیک – است. برای رفع این چالش، لازم است تمرکز بر توسعه ی رابطهای کاربرپسند و کم زمانبر باشد تا ارتباط بین پروفایل بیماران و درمانهای مناسب را به سادگی فراهم کند.
در نتیجه ، شکل گیری تیمهای همکاریِ فراگیر و بینارشت های متشکل از متخصصان بالینی، ترجمه ای و محاسباتی، نقشی کلیدی در یکپارچه سازی دیدگاهها و روششناسی های متنوع خواهد داشت و در نهایت، به پیشرفت دانش و مدیریت دردهای مزمن کمک شایانی میکند.
منبع: www.sciencedirect.com


بدون دیدگاه